O que acontece quando o pipeline aprende a buscar.
A transição de uma interface de inferência puramente conversacional para um pipeline híbrido — com RAG persistente (ChromaDB + Ollama) e busca web em tempo real — impôs desafios operacionais severos a uma infraestrutura focada em CPU. Aqui estão os números e as correções.
Da conversa simples ao pipeline híbrido
Somar RAG persistente e busca web em tempo real a uma interface antes puramente conversacional expôs gargalos de rede interna no Docker, limites de I/O em lote e retenção de memória de modelos — todos amplificados por rodar inteiramente em CPU.
Quatro eixos de correção no pipeline
Para viabilizar a arquitetura e eliminar os gargalos operacionais, quatro frentes principais foram trabalhadas — da rede interna do Docker ao ciclo de vida do banco vetorial.
Unificação de redes no Docker Compose
Remoção da diretiva external: true isolada do Streamlit, consolidando ollama, kafka, airflow e streamlit-app na mesma rede de bridge. Endereçamento migrado de localhost:11434 para http://ollama:11434.
Processamento de embeddings em lotes
A ingestão de PDFs enviava centenas de trechos simultâneos ao endpoint de embeddings, gerando timeouts. A rotina foi reescrita para fatiar as chamadas em lotes de 10 chunks, com progresso via st.progress.
Multi-model concurrency & keep-alive
Por padrão, o Ollama carrega um modelo por vez, descarregando o de embeddings para subir o de chat (e vice-versa). Configuramos OLLAMA_NUM_PARALLEL=2, OLLAMA_MAX_LOADED_MODELS=2 e OLLAMA_KEEP_ALIVE=30m.
Resiliência & limpeza de cache
Correção do ciclo de vida da coleção vetorial no Streamlit via @st.cache_resource.clear(), evitando referências órfãs que quebravam a interface com exceções NotFoundError.
O mesmo hardware, três cenários de carga
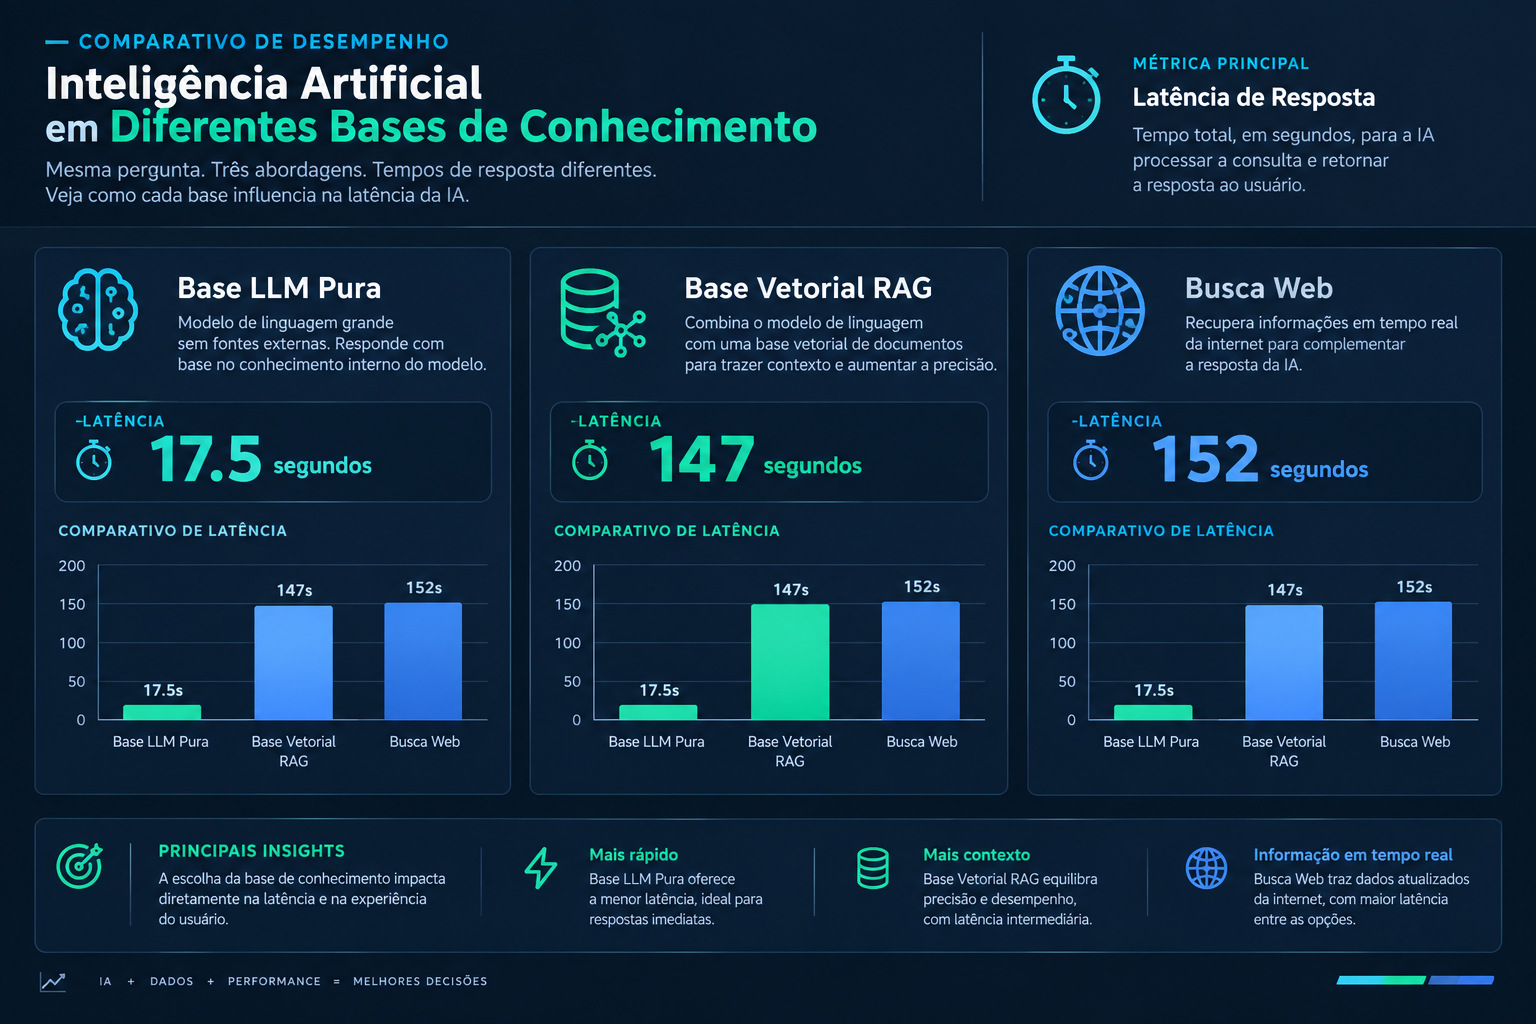
Tempos reais de execução medidos em ambiente local, inteiramente em CPU, comparando inferência pura, RAG vetorial e busca web em tempo real.
| Cenário de execução | TTFT | Tempo total de geração | Streaming efetivo | Sobrecarga de pré-processamento |
|---|---|---|---|---|
| Base LLM pura | 17.52 s | 217.77 s (~3.6 min) | 200.25 s | Baseline (prompt evaluation simples) |
| Base vetorial RAG | 147.01 s | 343.53 s (~5.7 min) | 196.52 s | +129.49 s (vetorização da query + contexto denso) |
| Internet / DuckDuckGo + LLM | 152.16 s | 352.07 s (~5.8 min) | 199.91 s | +134.64 s (I/O web + parsing de snippets + prompt denso) |
Consistência na escrita, gargalo na largada
Separar o "tempo até começar a responder" do "tempo de escrita da resposta" revela onde a CPU realmente sofre.
-
01
Prompt Evaluation Cost (KV Cache)
Injetar 2 a 3 chunks de documentos ou múltiplos snippets de busca web adiciona milhares de caracteres ao system prompt. O processador precisa calcular os tensores de atenção de todo o contexto antes de emitir o primeiro token.
-
02
Ciclo de embeddings síncrono
No cenário com ChromaDB, a CPU executa primeiro o modelo de embeddings para codificar o vetor da pergunta, e só depois entrega a fila de execução para o modelo generativo.
Reduzir o TTFT sem perder a fundamentação dos dados
Três frentes para atacar o gargalo identificado, sem abrir mão do enriquecimento por RAG ou busca web.
-
01
Limitar a janela de contexto (num_ctx)
Reduzir a alocação padrão para
num_ctx: 2048nas opções do Ollama, aliviando o uso de cache na memória. -
02
Truncamento de chunks RAG
Priorizar a recuperação de top-2 trechos de tamanho moderado (600 a 800 caracteres) em vez de lotes volumosos de texto.
-
03
Embeddings em serviço isolado ou offload
Delegar a geração de vetores a bibliotecas leves em C++ (ex: FastEmbed / ONNX Runtime), para não concorrer com o processo principal do Ollama.
As recomendações já mostram resultado
Duas rodadas de medição em produção, com as recomendações aplicadas de forma incremental: primeiro FastEmbed + reserva de um core de CPU para o SO, depois a redução do tamanho dos chunks recuperados por cima disso.
| Rodada | Pergunta feita | Início da resposta | Concluído em | Latência (TTFT) | Tempo total |
|---|---|---|---|---|---|
| CPU Threads & FastEmbed | 09/09/2026 07:17:22 | 07:19:08 | 07:22:18 | 106.60 s | 296.39 s |
| + Redução de Chunks | 09/09/2026 07:32:06 | 07:34:05 | 07:36:30 | 118.34 s | 263.55 s |
Concorrência é um problema de arquitetura, não só de hardware.
O gargalo não estava na CPU em si, mas no jeito como os serviços disputavam ela ao mesmo tempo. Ajustar a orquestração recuperou a viabilidade do pipeline híbrido.